لماذا Redis؟ لنبدأ بسؤال بسيط: ما السرعة التي يستطيع بها النظام الوصول إلى البيانات في المستويات المختلفة من هرم الذاكرة والتخزين؟
الأرقام التالية تقريبية، فهي تختلف حسب العتاد وطبيعة العمل، لكنها توضح حجم الفارق:
L1 CPU cache: 0.5 ns
RAM:           100 ns (0.0001 ms)
SSD:       100,000 ns (0.1 ms)
HDD:    10,000,000 ns (10 ms)
لذلك قد يكون الوصول إلى RAM أسرع تقريبًا من الوصول إلى التخزين بما يتراوح بين 1,000 و100,000 مرة، بحسب نوع جهاز التخزين وطريقة الوصول التي نقارنها.
إذا كنا نهتم بسرعة الوصول إلى البيانات، فلدينا ذاكرة تخزين مؤقت داخل قواعد البيانات أصلًا، أليس كذلك؟ نعم، قواعد البيانات تستخدم التخزين المؤقت، لكن ذلك لا يزيل قاعدة البيانات نفسها من مسار الطلب.
على سبيل المثال، يتعامل PostgreSQL عادةً مع مستويين مهمين من التخزين المؤقت:
- Shared Buffers: ذاكرة PostgreSQL الخاصة. وهي تخزن صفحات قاعدة البيانات، وغالبًا ما تكون كل صفحة بحجم 8 KB، لا صفوفًا أو كائنات منفردة. فإذا احتجت إلى صف حجمه 200 Byte فقط، فالوحدة التي تُخزّن هي الصفحة التي تحتويه.
- ذاكرة صفحات نظام التشغيل (OS Page Cache): قد يحتفظ نظام التشغيل أيضًا ببيانات نظام الملفات، وغالبًا ضمن صفحات حجمها 4 KB. ولا يملك PostgreSQL سيطرة كاملة على هذه الذاكرة، لأن الـKernel يديرها وقد يطرد بعض البيانات عندما يحتاج إلى الذاكرة لغرض آخر.
وهنا تظهر المشكلة الأولى: قد تخزن قاعدة البيانات بيانات أكثر مما يحتاجه التطبيق، فتستهلك مساحة من الذاكرة، بينما لا يملك التطبيق سيطرة كاملة على ما يبقى في ذاكرة نظام التشغيل. وقد تُطرد البيانات التي كانت تُستخدم بكثرة عندما يحتاج النظام إلى تلك الذاكرة لغرض آخر.
المشكلة الثانية: حتى لو كانت صفحة قاعدة البيانات المطلوبة موجودة في الذاكرة، ماذا يحدث عندما ينفذ التطبيق استعلامًا مثل الآتي؟
SELECT my_perfect_cached_data
FROM table
WHERE id = 'abc';
قد يكون الصف موجودًا في الذاكرة فعلًا، لكن قاعدة البيانات لا تزال بحاجة إلى تنفيذ عدة أعمال:
- تحليل الاستعلام والتحقق من صحته النحوية، وهذا يتطلب وقتًا من وحدة المعالجة المركزية.
- تخطيط الاستعلام واختيار طريقة الوصول المناسبة، مثل استخدام Index Scan أو خطة أخرى. ويمكن لقواعد البيانات إعادة استخدام الخطط المحضّرة في بعض الحالات، لكن التخطيط يظل جزءًا من عمل قاعدة البيانات عندما تكون هناك حاجة إلى خطة.
- تطبيق قواعد التزامن وإمكانية رؤية البيانات. والقراءة العادية في PostgreSQL لا تحصل غالبًا على Row Lock يمنع العمليات الأخرى، لأن PostgreSQL تستخدم MVCC، لكنها لا تزال تجري فحوصات المعاملة وإمكانية الرؤية.
- المرور عبر الفهرس، عند استخدامه، للعثور على الصفحة التي تحتوي على الصف.
- التعامل مع صفحة قاعدة البيانات كاملة، حتى لو كان التطبيق يحتاج إلى جزء صغير من صف واحد فقط.
- تفسير بنية الصفحة واستخراج الصف المطلوب.
- وأخيرًا، تحويل النتيجة إلى PostgreSQL Wire Format قبل إرسالها إلى التطبيق.
يمكن تحسين بعض هذه الأعمال، لكن لا يمكن إلغاؤها بالكامل ما دمنا نستخدم قاعدة بيانات علائقية كاملة. فهي جزء من الوظائف التي تمنح PostgreSQL المعاملات والاتساق ومرونة الاستعلامات والقدرة على الاحتفاظ بالبيانات.
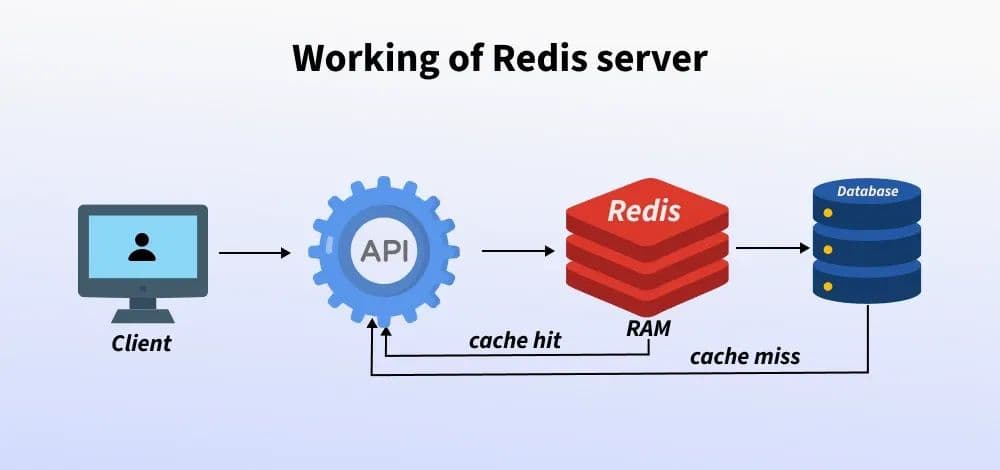
ماذا لو امتلكنا أداة منفصلة تستطيع القيام بأمرين؟
- العمل كطبقة تخزين مؤقت سريعة لمجموعة صغيرة من البيانات التي يقرأها التطبيق باستمرار.
- تجاوز آليات قاعدة البيانات العلائقية في مسارات الاستخدام الشديد والمحددة بعناية.
هذه الأداة موجودة فعلًا، واسمها Redis.
لا يعني هذا أن علينا استبدال PostgreSQL. فكثير من التطبيقات واسعة النطاق تستخدم Redis إلى جانب قاعدة البيانات الأساسية: تبقى PostgreSQL مصدر الحقيقة، بينما تتولى Redis تقديم البيانات كثيرة الطلب أو المؤقتة أو المشتقة بزمن وصول منخفض جدًا.
السؤال التصميمي المهم ليس: «هل أضع كل شيء في Redis؟» بل: «ما البيانات التي تُستخدم بكثرة بما يكفي، وتستحق التخزين المؤقت، وكيف سيتعامل التطبيق مع انتهاء الصلاحية وإبطال القيمة وفشل العثور عليها والقيم القديمة؟»