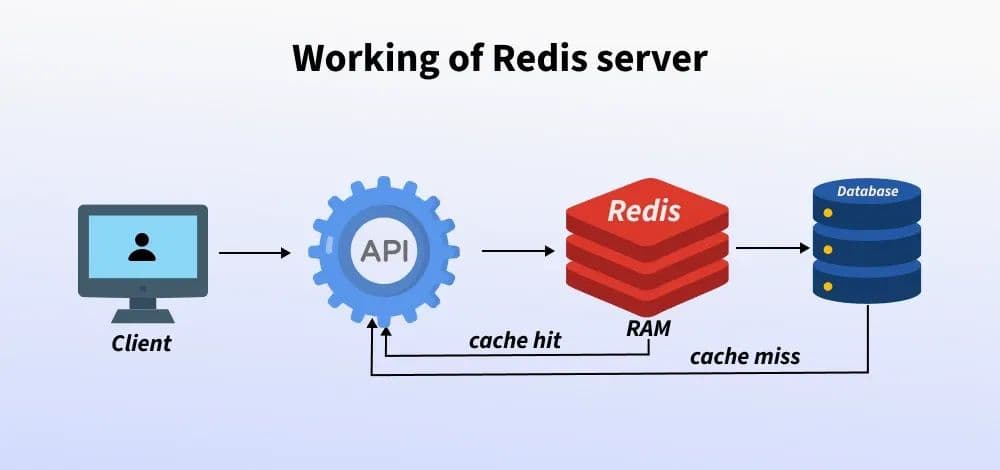
Redis قاعدة بيانات تعمل في الذاكرة، ولذلك فهي سريعة. وقد رأينا ذلك في الجزء الأول، لكن هذا التفسير صحيح وغير كامل في الوقت نفسه.
تقرأ قواعد البيانات الحديثة نسبة كبيرة من البيانات من الذاكرة. ففي كثير من الأنظمة الحقيقية، يستطيع PostgreSQL قراءة كل ما يحتاج إليه تقريبًا من Shared Buffers من دون الرجوع إلى القرص. كما يمكن لـPrepared Statements والخطط القابلة لإعادة الاستخدام تقليل جزء من عمل التحليل والتخطيط المتكرر.
إذًا، السؤال الأهم هو: إذا كان النظامان يقرآن البيانات من RAM، فلماذا يمكن أن يختلف أداؤهما بهذا الشكل تحت الضغط؟
لنفترض أفضل حالة ممكنة لـPostgreSQL: الصفحات المطلوبة موجودة أصلًا في الذاكرة، والتطبيق يستخدم Prepared Statements وخططًا مخزنة مؤقتًا. تخيل تطبيقًا لعرض نتائج المباريات أثناء نهائي كأس العالم، حيث يسأل مئات الآلاف من المستخدمين السؤال نفسه في الوقت ذاته تقريبًا: «ما النتيجة الحالية؟»
1. التحليل وتجهيز التنفيذ
مع استخدام Prepared Statements والخطط المخزنة، يستطيع PostgreSQL تجنب جزء كبير من عمل التحليل والتخطيط المتكرر. وقد تبقى تكلفة الأمر الواحد في Redis أقل، لكن الفرق هنا أقرب إلى تكلفة منخفضة مقابل تكلفة منخفضة جدًا، وليس إلى الفرق بين سرعة القرص وسرعة RAM.
2. العثور على القيمة
لا يزال على PostgreSQL أن يجيب عن السؤال التالي: أين يوجد الصف الذي يحتوي على القيمة المطلوبة؟ حتى مع وجود خطة تنفيذ مخزنة، قد يحتاج Index Scan إلى البدء من الجذر في B-tree، ومقارنة المفاتيح، والمرور عبر العقد الداخلية حتى يصل إلى العقدة الطرفية Leaf Node.
يحتوي الإدخال الموجود في العقدة الطرفية على TID (Tuple Identifier)، وهو مؤشر إلى موقع نسخة الصف داخل الجدول. ويكون البحث في B-tree عادةً بتعقيد O(log n)، أي أن مقدار العمل يزداد مع ارتفاع الشجرة، مع أن التخزين المؤقت والارتفاع الصغير للفَهارس العملية يجعلان البحث فعالًا في الواقع.
أما Redis فتجيب عن سؤال أضيق: ما القيمة المرتبطة بهذا المفتاح؟ ففي البحث المعتاد عن String Key، تستخدم Redis جدول تجزئة Hash Table، ويكون الوصول في المتوسط O(1)، مع اعتماد النتيجة الفعلية على سلوك جدول التجزئة وتفاصيل التنفيذ.
يمكن تصور الفرق بالشكل التالي:
PostgreSQL: key → index structure → tuple location → row
Redis:       key → hash-table entry → value
3. فحص الرؤية باستخدام MVCC
يستخدم PostgreSQL آلية Multi-Version Concurrency Control (MVCC)، أي التحكم بالتزامن عبر إصدارات متعددة. وهذا يعني أنه قد توجد عدة نسخ من الصف نفسه، وأن كل Transaction تقرأ البيانات وفق Snapshot محدد. لذلك يجب على PostgreSQL فحص بيانات المعاملة وإمكانية الرؤية لتحديد ما إذا كانت نسخة الصف التي عثر عليها ظاهرة لهذه القراءة.
لا تحصل القراءة العادية في PostgreSQL غالبًا على Row Lock حاجب، لكن فحوصات المعاملة والرؤية تظل ضرورية للحفاظ على صحة النتائج.
أما القراءة البسيطة في Redis فلا تنفذ فحص Snapshot مماثلًا لكل مفتاح. وتُعالج أوامر Redis ذريًا بالنسبة إلى الأوامر الأخرى على حلقة الأحداث نفسها، كما أن نموذج المفتاح والقيمة لا يقدم فحص رؤية لإصدارات الصفوف على طريقة PostgreSQL.
4. فك ترميز القيمة المخزنة
في PostgreSQL، تُخزّن القيمة داخل صفحة من صفحات قاعدة البيانات، وغالبًا ما يكون حجم الصفحة 8 KB. وقد يحتاج المحرك إلى استخدام Line Pointer الموجود في الصفحة للعثور على Tuple، وقراءة بياناتها الوصفية، وتحديد مكان العمود المطلوب ضمن تمثيل الصف.
أما Redis فتخزن القيمة في بنية بيانات مصممة لنموذج الأوامر الخاص بها. وفي البحث البسيط عن مفتاح، يمكنها الوصول إلى الإدخال في Hash Table ثم إعادة الكائن المرتبط به من دون التنقل داخل بنية صفحة علائقية وتمثيل Tuple.
تتعلق هذه المقارنة بالقراءات البسيطة. وقد يكون الفرق في العمل أكبر عند الكتابة في بعض أنواع الاستخدام، لكن Redis ليست أسرع تلقائيًا في كل عملية كتابة أو مع كل نموذج بيانات. فإعدادات المتانة وPersistence والنسخ المتماثل والشبكة والتسلسل وطبيعة الحمل كلها عوامل مؤثرة.
سرعة Redis لا تأتي من وجود البيانات في الذاكرة فقط، بل من أنها تنفذ عملًا أقل في حالات استخدام محددة. وهي تنفذ عملًا أقل لأنها تحل مجموعة أصغر من المشكلات مقارنةً بقاعدة بيانات كاملة؛ فهي لا توفر استعلامات PostgreSQL العلائقية، ولا نموذج المعاملات العام نفسه، ولا قواعد رؤية MVCC نفسها، ولا ضمانات المتانة والاتساق نفسها افتراضيًا.
وهذه هي المفاضلة الحقيقية: يمكن أن تكون Redis مسرّعًا ممتازًا لمسارات البيانات كثيرة الاستخدام والمختارة بعناية، بينما تبقى PostgreSQL مصدر الحقيقة وتتولى متطلبات الصحة والاتساق الأوسع.