إنها المباراة النهائية لكأس العالم. في الدقيقة الأخيرة، يقوم 500,000 مستخدم بتحديث تطبيقاتهم في اللحظة نفسها تقريبًا.
ويؤدي كل طلب إلى تنفيذ استعلام بسيط:
SELECT score
FROM matches
WHERE id = '00000000';
البيانات موجودة أصلًا في RAM، لكن هذه ليست القصة كاملة. إذ تصل كمية هائلة من الطلبات إلى طبقة قاعدة البيانات خلال فترة زمنية قصيرة جدًا.
تعالج قاعدة البيانات هذه الطلبات من خلال Workers، وعادةً ما تكون Processes أو Threads. وفي أي لحظة، لا يستطيع التنفيذ فعليًا على أنوية المعالج إلا عدد محدود من هذه الـWorkers.
تستطيع قواعد البيانات التعامل مع هذا الضغط بطرق متعددة، ولكل طريقة تكلفة وتعقيد تشغيلي خاص بها:
1. يمكن استخدام Read Replicas لتوزيع طلبات القراءة، لكن ذلك يضيف تحديات تتعلق بالنسخ والتوجيه والاتساق والتشغيل.
2. يمكن أن يقلل Connection Pooling تكلفة إنشاء الاتصالات، لكنه لا يجعل عددًا غير محدود من الاستعلامات يعمل في الوقت نفسه.
3. يمكن أن يدمج Micro-Caching على مستوى التطبيق الطلبات المتكررة، لكنه يضيف قرارات تتعلق بانتهاء الصلاحية وإبطال القيم.
والآن انظر إلى الصفحة المشتركة الموجودة في Buffer Pool. يستطيع أكثر من Worker قراءة الصفحة نفسها، لكنها ليست مجرد مجموعة غير منظمة من الـBytes. فقاعدة البيانات تحتفظ أيضًا ببيانات وصفية مشتركة عن الـBuffer الذي يحتوي الصفحة.
قد تتضمن هذه البيانات ما إذا كان الـBuffer صالحًا، وما إذا كان قابلًا لإعادة الاستخدام، وعدد الـWorkers الذين يعتمدون حاليًا على الصفحة. أما Buffer Pin فهو عداد للمراجع: يقوم الـWorker بزيادة العداد عندما يحتاج إلى الـBuffer، ثم يخفضه عند الانتهاء. ويساعد ذلك على منع طرد الصفحة أو إعادة استخدام الـBuffer أثناء وجود Worker ما زال يستخدمه.
لماذا تحتاج قاعدة البيانات إلى تنسيق هذه البيانات إذا كانت العملية مجرد قراءة؟ لأن مسار القراءة يغير حالة مشتركة أيضًا. فالعثور على الصفحة يُعد قراءة للبيانات منطقيًا، لكن عملية Pin وUnpin تعدلان البيانات الوصفية الخاصة بالـBuffer.
يمكن تبسيط التسلسل كما يلي:
- العثور على الـBuffer الذي يحتوي الصفحة.
- تحديث البيانات الوصفية المشتركة بأمان وزيادة عداد الـPin.
- قراءة محتوى الصفحة.
- تحديث البيانات الوصفية مرة أخرى بأمان وخفض عداد الـPin.
ويُطلق عادةً على آلية المزامنة التي تحمي الأقسام القصيرة من العمل على الحالة المشتركة اسم Latch. والـLatch ليس هو Buffer Pin نفسه: فالـPin يعبّر عن أن Worker يستخدم Buffer، بينما يحمي الـLatch أو آلية المزامنة المرتبطة به البيانات الوصفية أثناء تعديلها.
قبل أن يتمكن Worker من استخدام صفحة مشتركة بأمان، قد يحتاج إلى تنسيق عمله مع Workers أخرى تتعامل مع حالة الذاكرة المشتركة نفسها. وقد يكون القسم المحمي قصيرًا جدًا، لكن فترات الانتظار القصيرة تتراكم عندما يستهدف عدد كبير من الـWorkers الصفحة أو الـBuffer الساخن نفسه.
بالعودة إلى مثال كأس العالم:
- قد يتنافس عدد كبير من الـWorkers على البيانات الوصفية الخاصة بالـBuffer نفسه.
- يجب عليهم تنسيق تحديثات البيانات الوصفية والوصول إلى البيانات ثم تحرير المراجع بأمان.
- يتقدم عدد أقل من الـWorkers بينما ينتظر الآخرون، فتزداد Tail Latency.
- وقد يستهلك المعالج وقتًا في تنسيق الوصول إلى الحالة المشتركة بدلًا من تقديم القيمة المطلوبة.
وهذا هو Latch Contention: قد لا تكون المشكلة في جلب الـBytes من RAM، بل في تنسيق عمل عدد كبير من الـWorkers حول هياكل قاعدة البيانات المشتركة. وقد يصل استخدام المعالج إلى مستويات عالية جدًا رغم أن الاستعلام يبدو بسيطًا.
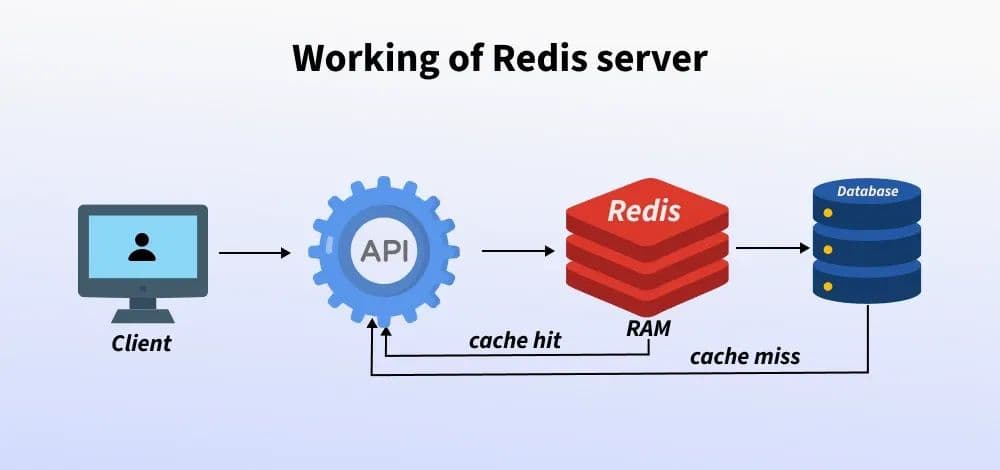
فماذا تفعل Redis بشكل مختلف؟ في نسخة Redis واحدة، تُنفَّذ الأوامر عادةً بالتسلسل على Event Loop رئيسية؛ أي إن أمرًا واحدًا يعمل في كل مرة ضمن مسار التنفيذ هذا. وبهذا لا تتعامل عدة Workers مع هياكل المفاتيح والقيم نفسها في الوقت ذاته، فلا يواجه التطبيق في القراءة البسيطة عن مفتاح نموذج التنسيق نفسه الخاص بصفحات الـBuffer وMVCC في PostgreSQL.
لكن هذا لا يعني أن Redis لا تستخدم أي تزامن أو Threads إطلاقًا. فقد تستخدم Threads في الخلفية لمهام مثل Persistence، كما يمكن استخدام I/O Threads في بعض الإعدادات. وتضيف Replicas وRedis Cluster اعتبارات خاصة بالتنسيق والاتساق. والنقطة الأضيق هي أن الأوامر البسيطة ضمن مسار تنفيذ Redis واحد تتجنب نموذج التنافس نفسه الموجود حول الـBuffer المشترك في PostgreSQL.
فهل يتفوق التنفيذ ذو الـSingle Thread دائمًا على التنفيذ متعدد الـThreads؟ لا. قد يكون فعالًا جدًا عندما تكون الأوامر صغيرة ومتوقعة وسريعة، لأنه يزيل تنافس الأقفال وتكلفة تبديل السياق. لكن أمرًا واحدًا طويل التنفيذ قد يمنع الأوامر الأخرى من التقدم على مسار التنفيذ نفسه، كما أن النسخة الواحدة تبقى محدودة بكمية العمل التي يستطيع خيط التنفيذ إنجازها.
تكون Redis سريعة هنا لأنها تستخدم نموذج بيانات أبسط ومسار تنفيذ أبسط لهذا النوع من الحمل. وهذه مفاضلة: توفر PostgreSQL مجموعة أوسع بكثير من الضمانات والقدرات، بينما تُستخدم Redis بأفضل شكل كمسرّع مصمم بعناية، لا كبديل شامل.